Agent 执行短任务时,模型通常能根据当前上下文决定下一步。但任务一长,问题就开始出现:忘记目标、漏掉前置检查、工具调用顺序错误,或者在同几个失败动作之间循环。
常见做法是给 Agent 加记忆,或者直接写死一套 workflow。前者保存了经验,却仍要让模型临时判断经验该用在哪里;后者步骤清楚,但维护成本高,也不容易根据运行结果自动调整。
这篇论文提出 Procedural Graph(PG):把“下一步可以做什么、在什么条件下做、容易犯什么错”存成一张独立于模型的流程图。Agent 每一步只读取当前位置附近的流程。跑完一批任务后,另一个 LLM 根据成功和失败轨迹修改图,并用验证集决定是否接受修改。
它处在自由 ReAct 和硬编码状态机之间:给 Agent 明确的流程提示,但不替 Agent 强制选择动作。
图里存什么
Procedural Graph 由节点和有向边组成:
- 节点可以是工具调用、技能、推理步骤或任务状态;
- 边表示一个步骤之后可以进入哪个步骤;
- 每条边带有
condition、guidance和pitfalls,分别说明适用条件、执行建议和常见错误。
例如,一个搜索 Agent 的流程可以写成:
Search → Read → Extract Evidence → Check Answer → Output如果当前节点是 Extract Evidence,系统会把 Check Answer 及其条件和注意事项交给 Agent,避免它跳过检查直接输出。
这和普通文本记忆的区别在于:步骤之间的依赖关系已经写进图里,Agent 不必每次从一堆历史经验中重新拼出顺序。
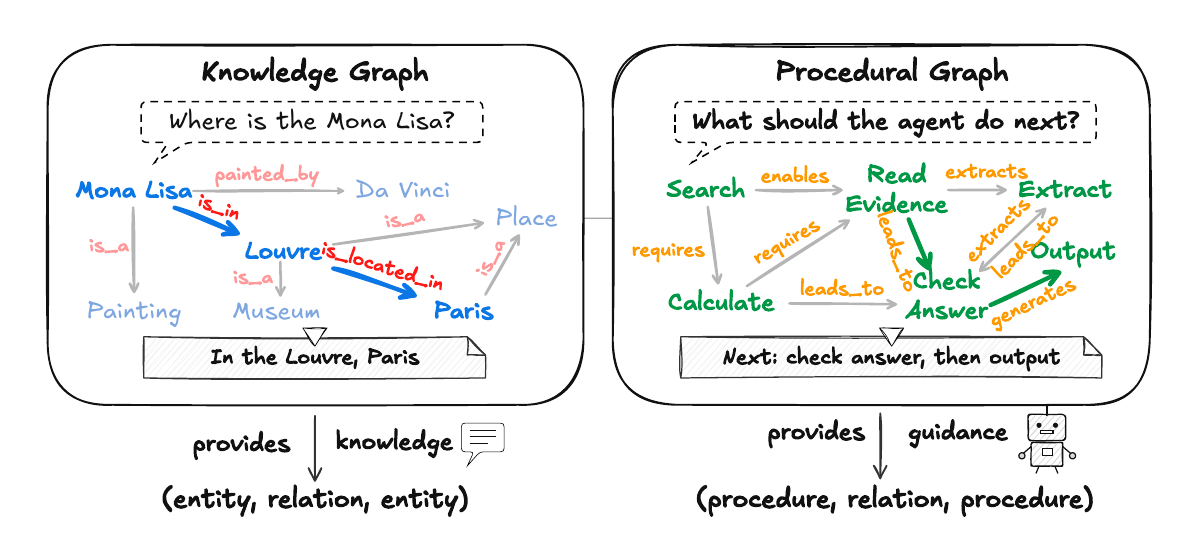
论文 Figure 1:知识图谱组织“是什么”,Procedural Graph 组织“下一步做什么”。来源:Lu 等,论文原文。
每一步怎么执行
论文中的在线执行流程很短:
当前任务 + 最近轨迹
        ↓
定位当前节点
        ↓
读取两跳以内的局部子图
        ↓
指导模型生成当前步骤提示
        ↓
执行模型选择动作并调用工具
当前节点根据 Agent 最近执行的动作匹配。默认只取两跳以内的局部子图,再结合最近三步轨迹生成提示。匹配失败时,系统才退回读取完整图。
指导模型(Guidance LLM)只负责把图中的静态规则改写成当前情境下的提示。执行模型(Solver)仍然可以自行推理和选择动作,所以 PG 是软指导,不是权限控制或确定性状态机。
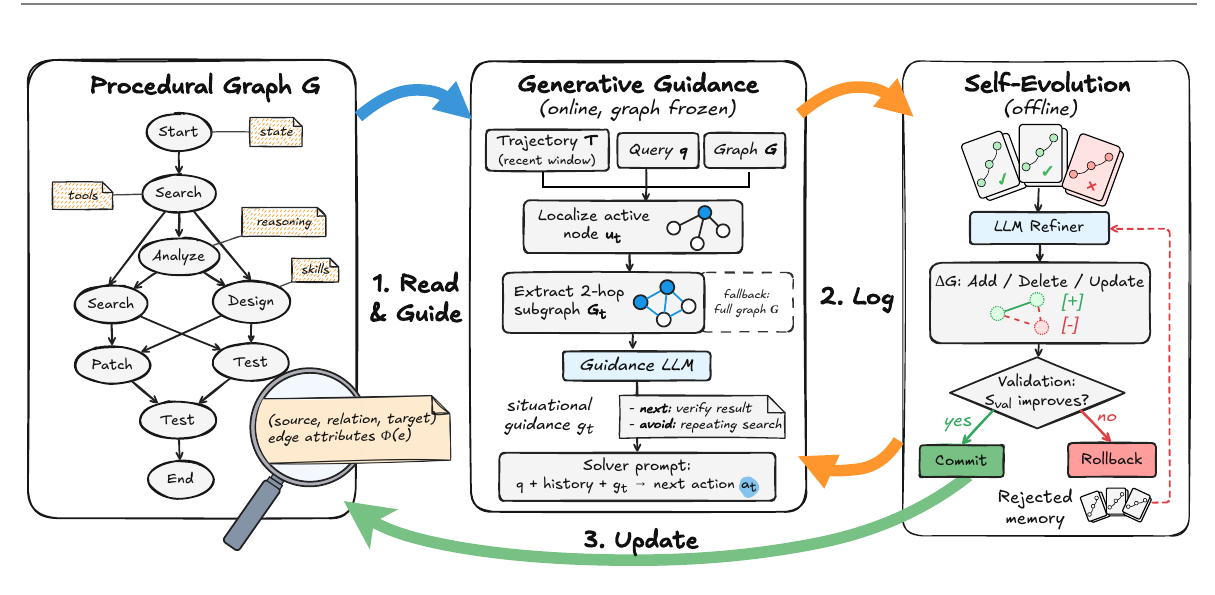
论文 Figure 2:左边是流程图,中间是在线局部指导,右边是离线修改、验证和回滚。来源:Lu 等,论文原文。
流程图怎么更新
PG 的“自我演化”发生在一批任务执行完之后,在线运行时图不会变化。
更新分为四步:
- 用当前图跑一批任务,保存轨迹和评分;
- 流程修改模型(Refiner LLM)对比高分与低分轨迹,提出新增、删除或修改节点和边;
- 检查候选图结构,并在独立验证集上重新运行;
- 验证成绩不下降才采用修改,否则回滚,并把失败方案存入被拒方案记录(rejection memory)。
修改对象是模型外部的流程图,不是模型权重。LLM 可以提议修改,但验证结果决定修改能否进入下一版。
实验说明了什么
主实验覆盖六个 benchmark 和四种 LLM,共 24 个“模型 × benchmark”组合。为了可比,所有方法使用相同的 ReAct 执行模型、工具接口和解码配置;需要训练轨迹的方法也使用同一批数据。PG 在其中 21 个组合中排名第一或并列第一;与每组最强 baseline 相比是 19 胜、2 平、3 负(§5.1,Table 1)。HotpotQA 上的差距较小,在部分模型上还会落后,收益并不是每个任务都一样。
EnterpriseArena 测试的是长周期经营决策:Agent 在企业财务模拟器中按月决策,最长运行 132 个模拟月,也就是 11 个模拟年度。每个月可以查询现金和市场状态、决定是否融资,再结账进入下个月;现金低于 0 时测试提前结束。模拟器会在第 32、59 和 112 个月触发三次事先不告知 Agent 的危机。
PG 主要改变的是工具调用的时机,而不是单纯增加调用次数。例如 Gemini 3.1 Pro 的完整周期生存率从 6% 提升到 34%,Claude Sonnet 4.6 从 44% 提升到 58%(§5.2)。
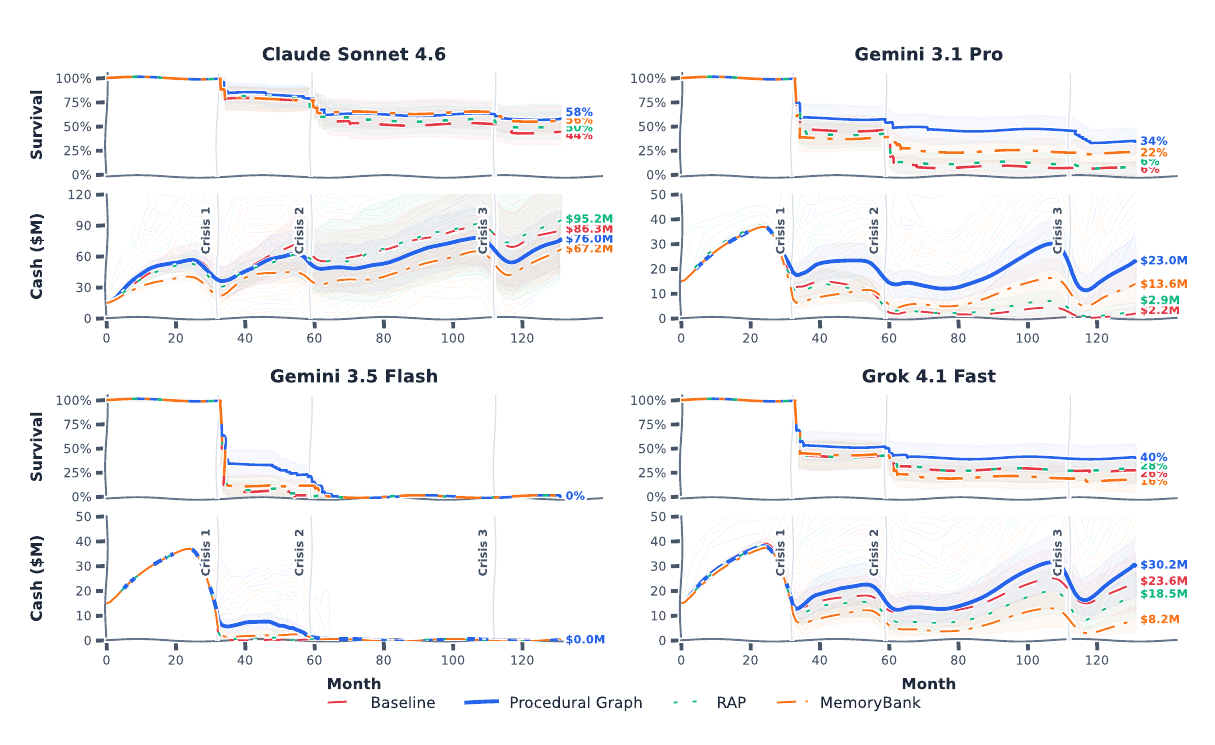
论文 Figure 3:四种 LLM 在三次危机中的生存率和现金变化。蓝线是 Procedural Graph,红线是无图 baseline。来源:Lu 等,论文原文。
构图实验还给出两个有用结果:
- 从只有
Start → End的最小骨架开始,经过多轮运行和验证,也能长出可用流程; - 一张错误的人工图曾把 MultiChallenge 成功率从 87.50% 降到 58.93%,带验证门的迭代更新把它恢复到 92.86%。只做一次静态更新反而继续下降到 53.57%(§5.3,Table 2)。
验证门和回滚不能省。LLM 生成的新流程不一定更好,不能直接覆盖当前版本。
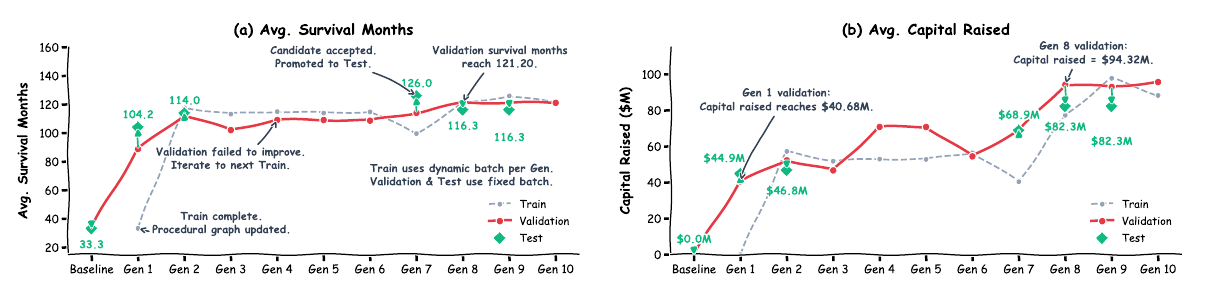
论文 Figure 4:十轮自我演化中的平均生存月份和融资额。灰线是训练结果,红线是验证结果,绿点是被接受版本的测试结果。来源:Lu 等,论文原文。
为什么只读局部图
把整张图全部塞进上下文会带来无关规则和额外 token。论文比较了完整图原样注入、完整图生成指导和局部图生成指导。局部方案在三个消融测试集上表现最好;相对“完整图 + 生成式指导”,token 用量降低了 14.8%–70.9%(§5.5,Table 3)。
局部图仍然有成本。与完全不用图的 baseline 相比,GDPval 和 ALFWorld 的执行步数减少了,但总 token 用量分别增加 33.4% 和 55.4%,因为每一步都多了一次指导模型调用。
这意味着 PG 更适合顺序、条件和失败恢复确实重要的长任务。几步就能完成的调用链,未必值得增加一层指导模型。
Agent 工程里怎么用
工程上可以先把一条长任务拆成少量状态和转换。例如兼容性维护 Agent:
检测上游版本
→ 复现问题
→ 判断问题位置
→ 生成修改方案
→ 修改
→ 回归测试
→ 人工批准
→ 发布
图中的边可以写明:复现成功后再进入修改、测试不通过时返回问题定位、发布前请求人工批准。这些内容只会提示执行模型如何行动,不会强制阻止状态转换。
部署、删除、付款和发布等高风险动作,仍然应该由状态机、代码、权限或审批机制硬性限制,不能只靠 PG 的提示。
这套设计还可以直接转成几个工程组件:
- 用 JSON 或 YAML 保存带版本的流程图,支持 diff 和回滚;
- 运行日志同时记录当前节点、实际动作、工具结果和最终评分;
- 指导层只读取局部子图,不把全部规则重复放进 prompt;
- 流程修改模型只生成候选 patch,验证器跑完测试后再决定是否合并。
如果任务量还很小,先手工维护图更合适。等积累了足够的成功和失败轨迹,而且任务有稳定的自动评分,再让 LLM 参与改图。
工程落地前要确认的限制
- 这是 2026 年 9 月发布的 arXiv 预印本,尚不能视为经过同行评审的结论。
- 自我演化依赖可量化的任务分数和独立验证集。现实任务如果没有可靠验收标准,验证门就无法判断候选图是否更好。
- 当前实现依靠最近动作和节点的精确匹配来定位。工具名、动作格式或接口改变,都可能导致定位失败。
- 部分数据集规模较小或使用 LLM Judge。EnterpriseArena 的自我演化实验中,训练、验证和测试数据集各只有 20 次独立运行。作者明确提醒,单次接受或拒绝可能只由一两次运行决定。
- 论文还没有证明学到的流程能稳定迁移到不同执行模型、工具接口或真实生产系统。
- 指导模型会增加延迟和 token 成本,需要和减少的错误、回退及人工处理成本一起评估。
对大多数团队来说,第一步不需要实现完整的自我演化系统。先把一条经常出错的长任务写成最小流程图,只取当前节点附近的规则,并用现有测试决定流程修改能否保留。等运行数据足够,再加入自动流程修改。